
Déploiement et mises à jour
Le parc se déploie avec colmena 🡕 : une commande construit et applique la configuration sur un ou plusieurs hôtes, à distance, depuis le poste admin.
Appliquer une configuration
Section intitulée « Appliquer une configuration »just apply <cible> [action] # alias : a- cible = nom d’hôte, motif (
'*'), liste (a,b) ou tag colmena (@server). - action =
switch(défaut),boot,testoubuild.
| Commande | Pour quoi |
|---|---|
just apply <cible> | Construire + activer sur la (les) cible(s) |
just apply-local | Appliquer sur la machine courante (alias al) |
just apply-verbose <cible> | Idem apply en mode trace (alias av) |
Déployer en sécurité
Section intitulée « Déployer en sécurité »Monter en confiance par l’action : chaque étape est moins risquée que la suivante.
just apply <hôte> build # télécharge + compile : 100 % sûr, rien n'est activéjust apply <hôte> test # active sans switcher : ni génération, ni bootjust apply <hôte> # switch : active et crée une nouvelle générationProgresser du cœur vers la périphérie : déployez les nœuds dans cet ordre, pour ne jamais vous couper l’accès à un nœud par celui qui le précède.

Mettre à jour
Section intitulée « Mettre à jour »Le système est figé par les flakes. Mettre à jour = rafraîchir les entrées, puis redéployer.
just update-flake # met à jour dnf/ + racine, commit les locksjust apply '*' # déploie la mise à jourMettre à jour le parc avec fleet-update
Section intitulée « Mettre à jour le parc avec fleet-update »fleet-update enchaîne toute la mise à jour en une commande : flakes,
construction de tous les hôtes, publication des fermetures sur le parc, test par
vagues (les hôtes dont dépend le réseau d’abord), puis activation définitive des
hôtes validés.
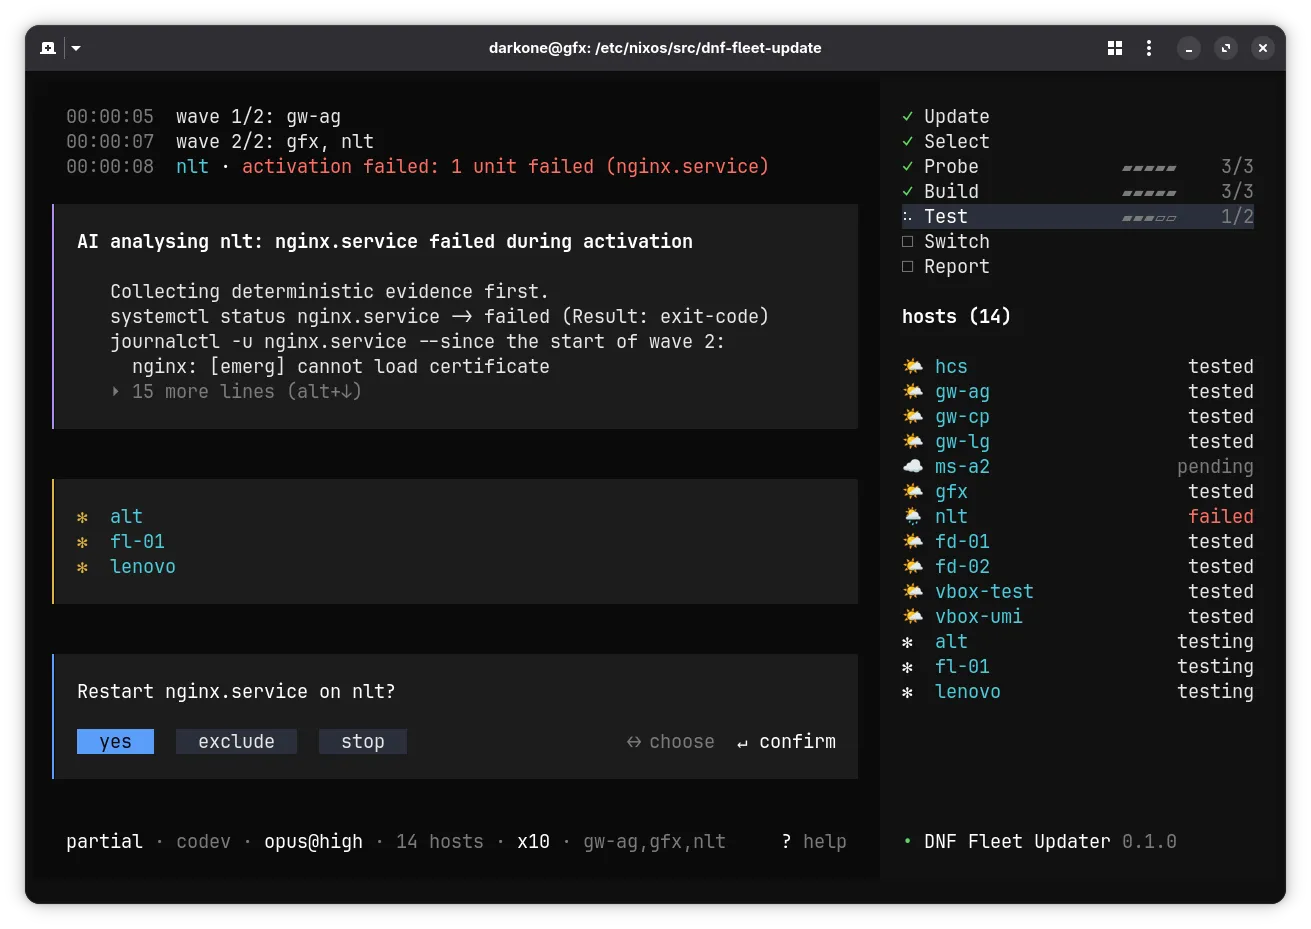
just fleet-update [options]La recette choisit l’outil à lancer, dans cet ordre :
| Situation | Outil lancé |
|---|---|
Co-développement (src/dnf-fleet-update/ présent) | Les sources, avec bun |
Module darkone.admin.fleet-update actif | La commande fleet-update installée |
| Autre cas | nix run .#fleet-update, selon le flake.lock du projet |
Le déroulé d’un lancement
Section intitulée « Le déroulé d’un lancement »- Mise à jour :
nix flake updatedu projet puis dednf/(co-développement),just clean, un commit par dépôt. - Sélection : hôtes, profils et zones lus dans
var/generated/, filtrés par--on; zone courante déduite de l’IP locale ; un builder élu par hôte. - Construction : tous les hôtes sélectionnés, joignables ou non, chacun sur son builder. Présence sondée par la connexion SSH de déploiement, qui joint aussi un hôte en déplacement.
- Publication : la fermeture de chaque hôte joignable est amenée dans son store, hors vagues, avant toute activation.
- Test :
switch-to-configuration test, une vague par profil ; la vague suivante démarre quand tous ses hôtes sont OK ou écartés. - Switch : tous les hôtes validés en test, d’un seul coup, hors ordre des vagues.
Trois options raccourcissent ce déroulé :
| Option | Effet |
|---|---|
--build-only | S’arrête après la construction ; en interactif, propose de continuer |
--skip-test | Pas de test : le switch se fait vague par vague, directement après la construction |
--skip-switch | Pas de switch : le lancement s’arrête sur ce que le test a laissé en place |
Construction distribuée
Section intitulée « Construction distribuée »La machine de déploiement ne doit pas être le goulot du parc. Chaque hôte est
donc construit par le builder élu pour lui. L’élection est recalculée à
chaque lancement depuis var/generated/, jamais déclarée : changer la
topologie de déploiement ne doit pas reconstruire le parc.
| Ordre | Builder retenu | Condition |
|---|---|---|
| 1 | L’hôte lui-même | Fonctionnalité auto-build ou roaming |
| 2 | L’hôte harmonia de sa zone | La zone en a un |
| 3 | L’hôte harmonia global | Il en existe un dans le parc |
| 4 | La machine de déploiement | Défaut |
La règle tient en une phrase : un builder doit pouvoir servir ce qu’il
construit. D’où le choix des hôtes harmonia, dont le /nix/store est déjà le
cache de leur zone, sans rien à amorcer. Une passerelle sans harmonia ne
convient pas : ses chemins ne sont dans aucun substituteur.
Le résultat reste chez le builder. C’est la publication qui l’amène ensuite aux hôtes de la zone, en LAN, par leur substituteur habituel.
features: ["auto-build"]L’option --no-distributed-build ramène tout au centre, quelle que soit
l’élection. C’est une échappatoire de mise au point : la règle vient du
parc, l’exception de la ligne de commande.
Ordre des vagues et hôtes critiques
Section intitulée « Ordre des vagues et hôtes critiques »Les valeurs par défaut du parc se déclarent dans config.yaml :
network: fleetUpdate: deploymentOrder: "hcs:gateway:server:[others]:laptop" criticalProfiles: "hcs:gateway:server"| Clé | Rôle |
|---|---|
deploymentOrder | Une vague de test par profil d’hôte, dans cet ordre |
criticalProfiles | Profils dont les échecs vont aussi au salon des incidents |
Profils séparés par :, [others] désigne les profils non listés. Bloc
facultatif : sans lui, l’outil applique les valeurs ci-dessus. Les options
--deployment-order et --critical-profiles priment sur config.yaml.
Délais et surveillance
Section intitulée « Délais et surveillance »Deux autres blocs facultatifs de config.yaml règlent les durées :
network: fleetUpdate: pingInterval: 15 timeouts: build: 10800 ssh: 30| Clé | Rôle | Défaut |
|---|---|---|
pingInterval | Secondes entre deux sondes de présence | 15 |
timeouts.<clé> | Durée maximale d’une opération, en secondes | selon l’opération |
Clés de timeouts, dans l’ordre du déroulé :
timeouts.<clé> | Défaut (s) |
|---|---|
flakeUpdate | 120 |
clean | 60 |
commit | 60 |
eval | 1200 |
build | 10800 |
publish | 3600 |
copy | 3600 |
activation | 300 |
ssh | 30 |
ping | 5 |
matrix | 30 |
killGrace | 10 |
Erreurs, diagnostic et réparation
Section intitulée « Erreurs, diagnostic et réparation »Une erreur courante doit se lire sans connaître Nix. L’outil tient une table de signatures : un motif reconnu dans la sortie d’une commande donne un message en clair, et l’action à prendre.
| Motif reconnu | Ce que ça signifie | Action |
|---|---|---|
mismatch in field 'narHash' | nix-eval-jobs n’est pas lié au même Nix que le système | Arrêt |
lacks a signature by a trusted key | Le compte de déploiement n’est pas trusted user sur cet hôte | Arrêt |
Le message s’affiche au fil du lancement (hint:), une seule fois, et se retrouve
dans la section Known errors du rapport. Il s’ajoute à la raison de l’hôte,
il ne la remplace jamais : la trace entière reste dans logs/.
| Action de la table | Ce que fait l’outil |
|---|---|
| Relance | Rejoue la commande, au plus trois fois, si elle est rejouable : évaluation, construction, copie de dérivation, tirage |
| Exclusion | Poursuit sans l’hôte ; s’il était déjà activé, le ramène d’abord à son origine |
| Arrêt | Arrête le lancement, sans poser de question |
Aucune signature ne demande de relance aujourd’hui : les deux entrées connues sont des arrêts.
Collecte déterministe. Un hôte qui échoue en restant joignable est interrogé
avant toute décision : systemctl status, liste des unités en échec, puis
le journal de chacune depuis le début de sa vague.
| Ce qui est collecté | Où ça va |
|---|---|
| Sortie complète des commandes et journaux | logs/<hôte>.diag du dossier de lancement |
| Unités en échec, extrait de l’erreur | Section Diagnostics du rapport, message d’incident |
Redémarrage des unités. Une activation qui se termine avec des unités en
échec laisse l’hôte en état error. L’outil tente alors une réparation simple.
- Attente de dix secondes : une unité lente à démarrer n’est pas une unité en échec.
systemctl restartde toutes les unités en échec, en une seule commande.- Relecture de la liste des unités en échec : c’est elle qui conclut, pas le code de sortie.
Tout repart → l’hôte reprend son cours, rejoint le switch avec les autres, et le
rapport note un probable problème d’ordre d’activation (section Notes).
Une unité résiste → l’hôte reste en error, son nom et celui de l’unité au
rapport.
Analyse par l’IA
Section intitulée « Analyse par l’IA »L’IA explique un échec : elle lit l’état du lancement, les journaux et,
au besoin, le code, puis rend une analyse en clair. Avec --ai-error-action repair elle peut ensuite agir sur les unités tombées, et rien d’autre
(voir Réparer un service). Le lancement n’attend jamais
après elle — une analyse qui échoue, dépasse son délai ou son budget laisse
l’hôte exactement où il était.
Deux options la commandent, toutes deux à none par défaut : rien ne
part vers une IA tant qu’on ne l’a pas demandé. Une troisième choisit l’outil.
| Option | Défaut | Rôle |
|---|---|---|
--ai-analysis none|passive|active | none | Profondeur d’analyse, et synthèse de fin de lancement au rapport |
--ai-error-action none|analysis|repair | none | Ce que l’IA fait quand un hôte échoue |
--ai-model <outil>[:<modèle>][@<effort>] | claude:opus@high | Outil et modèle, par exemple opencode:ollama/qwen3:32b |
--ai-context <texte> | aucun | Consigne ou contexte ajouté à tous les prompts IA |
just fleet-update --ai-analysis passive # rapport enrichi, rien de plusjust fleet-update --ai-error-action analysis # chaque échec est expliquéPar exemple, --ai-context "Répondre en français et rester concis." guide le
style des réponses. Pour ne pas le répéter à chaque lancement, posez-le une fois
pour l’hôte avec l’option aiContext du module : elle l’écrit dans
/etc/fleet-update/ai-context, que tout lancement lit, just fleet-update
comme le timer. L’option --ai-context prime sur ce fichier. À la reprise, le
contexte du lancement initial est repris ; un --ai-context explicite le
remplace.
# usr/machines/<hôte>/configuration.nixdarkone.admin.fleet-update.aiContext = "Répondre en français et rester concis.";Le modèle par défaut du parc se pose dans config.yaml, l’option prime :
network: fleetUpdate: aiModel: "claude:opus@high"Les outils IA ne sont pas une dépendance de l’outil. claude et opencode
sont cherchés dans le PATH ; l’option aiPackages du module les y met
pour le lancement quotidien. Absents ou refusés → un avertissement au fil
du lancement, une note au rapport, et la suite se déroule sans IA.
Ce que l’IA a le droit de faire
Section intitulée « Ce que l’IA a le droit de faire »L’IA n’a ni shell ni SSH libre. Elle n’agit que par les outils de
fleet-update, et le niveau demandé fixe la liste qu’on lui présente : ce
qu’elle n’y voit pas, elle ne peut pas le demander.
| Niveau | Outils présentés |
|---|---|
passive | État du lancement, diagnostic d’un hôte, journaux de construction et d’activation, avertissements du lancement regroupés |
active, analysis | + lecture, recherche et liste du code (projet et dnf/), unités et journaux des hôtes (unités utilisateur comprises), en lecture seule |
repair | + une action sur les unités tombées d’un hôte, et l’édition du code qui les décrit |
Le niveau retenu est le plus élevé des deux options : --ai-analysis passive --ai-error-action analysis donne active. Les outils intégrés de
claude et d’opencode sont coupés, et les instructions que ces outils
ramasseraient dans le projet (CLAUDE.md, réglages utilisateur) sont
neutralisées : l’IA ne voit que ce qu’on lui montre.
| Garde-fou | Effet |
|---|---|
| Chemin de lecture | Confiné au projet et à dnf/, après résolution des liens ; usr/secrets/ et .trash/ refusés |
| Hôte, unité | Vérifiés contre la table du lancement avant toute commande |
| Extraits | 200 lignes de journal, 400 lignes de source, tronqués par la fin : l’erreur est en bas |
| Délai, budget | 300 secondes par analyse ; budget en dollars pour claude |
Chaque appel d’outil laisse une trace — une ligne au fil du lancement
(AI reads usr/modules/nginx.nix) et une ligne dans logs/ai.log du dossier de
lancement. Un appel refusé par un garde-fou est tracé aussi, avec sa raison.
Quand elle intervient
Section intitulée « Quand elle intervient »- Un hôte échoue, avec
--ai-error-action≠none: après la collecte déterministe et le redémarrage des unités, avant la question qui décide de son sort. L’hôte porteAI analysisen magenta pendant ce temps, puis revient à son état. - Un hôte se rétablit après un redémarrage d’unités, avec
--ai-analysis≠none: l’analyse explique l’ordre d’activation, sans toucher à l’état de l’hôte. - Fin de lancement, avec
--ai-analysis≠none: une synthèse de l’ensemble, écrite avant le rapport qui la porte. - Fin de lancement, avec
--ai-analysis active: une revue des avertissements, qui dépose des suggestions d’amélioration. - Touche
a, à tout moment : une question libre. Elle reçoit une réponse même sous--ai-analysis none— sans aucun outil :nonesupprime les outils et l’analyse automatique, pas la conversation.
Réparer un service
Section intitulée « Réparer un service »--ai-error-action repair ouvre une seconde session sur l’hôte, juste après
l’analyse et dans l’état AI repair. Le premier de ses outils agit sur les
services : systemctl start, stop, restart ou reset-failed sur les
unités que le lancement a vues tomber. C’est le geste à préférer : il est
local et réversible. Quand il ne suffit pas, l’IA corrige le code
(Réparer par le code).
just fleet-update --ai-error-action repair- Le redémarrage groupé déterministe a échoué : l’hôte reste en
error. - L’IA analyse, dans l’état
AI analysis, en lecture seule. - L’IA répare, dans l’état
AI repair: elle agit, puis relit les unités en échec. - Plus rien en échec → l’hôte reprend son cours et rejoint le switch. Sinon → la question habituelle,
revert/keep/stop/rollback.
| Garde-fou | Effet |
|---|---|
| Unités | Seules celles que la collecte a vues en échec sur cet hôte ; toute autre est refusée |
| Hôte | Refusé s’il n’est pas en cours de réparation : une session de lecture n’agit jamais |
| Essais | Trois actions par hôte, refus non compris ; la quatrième est refusée |
| Arrêt en cours | Un lancement qui s’arrête ne répare rien : c’est une opération nouvelle |
| Confirmation | En interactif, une question à boutons avant chaque action : apply ou skip |
En non interactif (timer de nuit, --no-ui), l’action passe sans demander.
Elle est strictement moins risquée que ce que le lancement fait déjà sans
témoin : la réparation déterministe redémarre toutes les unités en
échec de l’hôte.
Chaque action est comptée, pas seulement tracée : elle se retrouve dans
state.json et dans la section AI repair du rapport, refus compris, avec sa
raison. Un hôte réparé porte aussi une note au rapport.
Réparer par le code
Section intitulée « Réparer par le code »Quand aucun redémarrage ne peut aider, l’IA écrit la correction dans le projet, la valide, la commite, et l’hôte seul est reconstruit puis redéployé.
edit_coderemplace un passage exact (présent une seule fois), ou réécrit un fichier en entier. L’arbre git doit être propre avant la première édition, et le diff part danslogs/ai.log.validatelance le nettoyage du projet, puis réévalue et reconstruit cet hôte seul.commitécritfix(<scope>): <sujet>, le scope nommant ce que la correction touche (fix(nginx): …). En co-développement,dnf/est commité d’abord, puis le projet et son lock réaligné.- L’hôte repasse en
builtavec son nouveau chemin ; sa vague le sert une fois de plus : copie, activation, conclusion.
| Garde-fou | Effet |
|---|---|
| Chemins | Le projet, et dnf/ en co-développement ; jamais usr/secrets/, .trash/, .git/, var/generated/, etc/config.yaml ni un *.lock |
| Hors co-développement | dnf/ est un chemin du store : l’écrire est refusé, et n’aurait rien changé |
| Arbre | Sale avant la première édition → refus : un commit de réparation ne porte que la correction |
| Essais | Un essai est un changement. Valider et commiter n’en coûtent aucun, sinon corriger coûterait trois fois plus que redémarrer |
| Hooks | Jamais contournés : le commit passe par la porte du dépôt comme n’importe quel autre |
| Message | dnf/ est publié : un commit du framework qui nomme un hôte du parc est refusé |
Suggestions d’amélioration
Section intitulée « Suggestions d’amélioration »Avec --ai-analysis active, le lancement se termine par une revue de ses
avertissements : option renommée ou dépréciée, changement qui ferait
taire un avertissement, problème à investiguer. L’IA propose, elle ne change
ni le code ni le parc.
- Les avertissements de tous les journaux du lancement sont regroupés par forme : le même sur dix hôtes compte une fois. Aucun avertissement → aucune revue, rien n’est payé.
- L’IA lit les suggestions déjà déposées, puis cherche dans le code d’où vient chaque avertissement.
- Chaque constat utile devient un fichier
var/deployments/suggestions/<slug>.md: quoi, où (fichier:ligne), pourquoi, et l’amélioration proposée. - La section Suggestions du rapport liste ce que le lancement a déposé ou revu. Rien ne part dans Matrix : ce n’est pas une alerte.
Les fichiers survivent aux lancements. Un constat qui revient ne réécrit
pas son fichier : seules les lignes Last seen et Runs de l’en-tête
bougent.
# Replace a deprecated nginx option
- Status: open- First seen: 20260101T020000Z-full- Last seen: 20260108T020000Z-full- Runs: 4
The option is deprecated upstream: `usr/modules/web.nix:12`, …| Pour | Faire |
|---|---|
| Faire taire une suggestion | Écrire Status: ignored dans son en-tête : elle reste suivie, hors du rapport |
| L’oublier | Supprimer le fichier : un constat qui revient repart de zéro |
| L’appliquer | Corriger le code, puis supprimer le fichier |
La portée suit le mode : en co-développement, le projet et dnf/ ;
sinon, le projet seul (un constat que seul le framework corrige n’est pas
déposé).
Rapport et alertes Matrix
Section intitulée « Rapport et alertes Matrix »Chaque lancement écrit son dossier dans var/deployments/<date>-<mode>/ :
report.md (le rapport), state.json (l’état que --resume reprend),
events.jsonl et les journaux par hôte. Le chemin s’affiche en fin de lancement.
Le rapport détaille ce que le lancement a réellement fait :
| Section | Ce qu’elle donne |
|---|---|
| Steps, Waves | Durée de chaque étape, composition et durée de chaque vague |
| Builders | Qui a construit quoi, replis compris |
| Copies | Par hôte : chemins tirés et par quel substituteur, chemins poussés, volume |
| Zones without a cache | Zones du lancement qu’aucun harmonia ne sert |
| Hosts not deployed | Hôtes restés de côté, et la raison |
| Diagnostics | Par hôte en échec : unités en échec, puis extrait de l’erreur |
| Notes | Ce que le lancement a constaté : ordre d’activation probable après un redémarrage d’unités |
| AI analysis | Analyse de l’IA : une entrée par hôte analysé, puis la synthèse du lancement |
| AI repair | Actions de l’IA : hôte, action, issue, et la raison d’un refus. Un commit de réparation apparaît aussi dans l’en-tête, Repaired in flight |
| Suggestions | Suggestions d’amélioration déposées ou revues par le lancement, hors celles ignorées |
| Known errors | Pièges reconnus par la table de signatures, en clair |
L’option --send-report envoie ce rapport aux salons du
bot d’alertes, installé au préalable par
just configure-alert-bot.
| Situation | Salon | Contenu |
|---|---|---|
| Lancement terminé | warnings | Résumé : hôtes par état, durée, erreurs connues |
| Hôtes critiques non déployés | incidents | Message séparé : hôtes concernés, raisons et unités en échec |
| Arrêt sur erreur | incidents | Erreur qui a arrêté le lancement, puis résumé |
Un hôte est critique quand son profil figure dans criticalProfiles. Après un
arrêt, les hôtes laissés en test complètent le message d’incident : un
redémarrage les ramènerait à leur génération précédente.
Seule la synthèse de fin de lancement rejoint le message, jamais les
analyses par hôte, et elle y est bornée à six lignes : au-delà, le message
renvoie à report.md. Un salon d’alertes n’est pas un rapport.
Le message reprend l’en-tête du rapport, le code de sortie dans le titre :
**Fleet Update Report** (1)
Error: srv-ag: activation failed
- Started at 2026-09-17 02:00:00 UTC, duration: 4m12s- Options: partial run, selection gw-*, test skipped, 10 in parallel- Hosts: 5 deployed (hcs, gw-ag, pc-ag, gw-cp, lt-cp), 1 failed (srv-ag)- Run stopped on errorExécution quotidienne
Section intitulée « Exécution quotidienne »Sur l’hôte de déploiement, le module installe l’outil et, avec timer.enable,
lance chaque jour fleet-update --no-ui :
# usr/machines/<hôte>/configuration.nixdarkone.admin.fleet-update = { enable = true; user = "admin"; aiContext = "Répondre en français et rester concis."; timer.enable = true;};| Option | Défaut | Rôle |
|---|---|---|
user | aucun | Propriétaire du projet : git, clé age, IA, Matrix |
workDir | /etc/nixos | Projet consommateur sur le disque |
aiContext | null | Contexte ajouté aux prompts IA de tout lancement sur l’hôte, écrit dans /etc/fleet-update/ai-context, même sans enable ; --ai-context le remplace |
timer.onCalendar | *-*-* 04:00 | Heure de lancement |
timer.extraArgs | [ ] | Options ajoutées à --no-ui, --send-report par exemple |
timer.timeout | 6h | Durée maximale d’un lancement |
Cache binaire
Section intitulée « Cache binaire »Deux services se combinent pour éviter de recompiler ou de retélécharger les dérivations à chaque déploiement.
| Service | Rôle |
|---|---|
harmonia | Sert le /nix/store local, signé, directement aux hôtes (LAN, ou VPN s’il est global). |
nix-cache | Proxy nginx par zone qui met en cache le cache public cache.nixos.org sur la passerelle. |
Un hôte harmonia a un second rôle : il est le
builder élu de sa zone, parce qu’il sait servir ce
qu’il construit.
Un hôte interroge ces sources dans l’ordre de priorité suivant. La première récupération depuis Internet est ainsi mutualisée pour toute la zone.
| Priorité | Source | Portée |
|---|---|---|
| 20 | harmonia de la zone | LAN, ce que la zone a compilé |
| 35 | proxy nix-cache de la zone | LAN, miroir mutualisé du cache public |
| 40 | cache.nixos.org en direct | filet de sécurité si la passerelle est HS |
| 45 | harmonia global | dernier recours, par le VPN |
Ferme de build
Section intitulée « Ferme de build »Récupérer un paquet et le construire sont deux besoins distincts. Le cache binaire ci-dessus couvre le premier. Pour le second, un hôte puissant du réseau peut prendre à sa charge les compilations longues d’un hôte d’administration.
Déclarez-le par la fonctionnalité build-farm :
features: ["build-farm"]Chaque hôte d’administration l’ajoute alors à ses nix.buildMachines, joint en
SSH par le compte de déploiement nix. Rien d’autre à configurer : la clé
et l’autorisation sont déjà en place sur tout le parc.